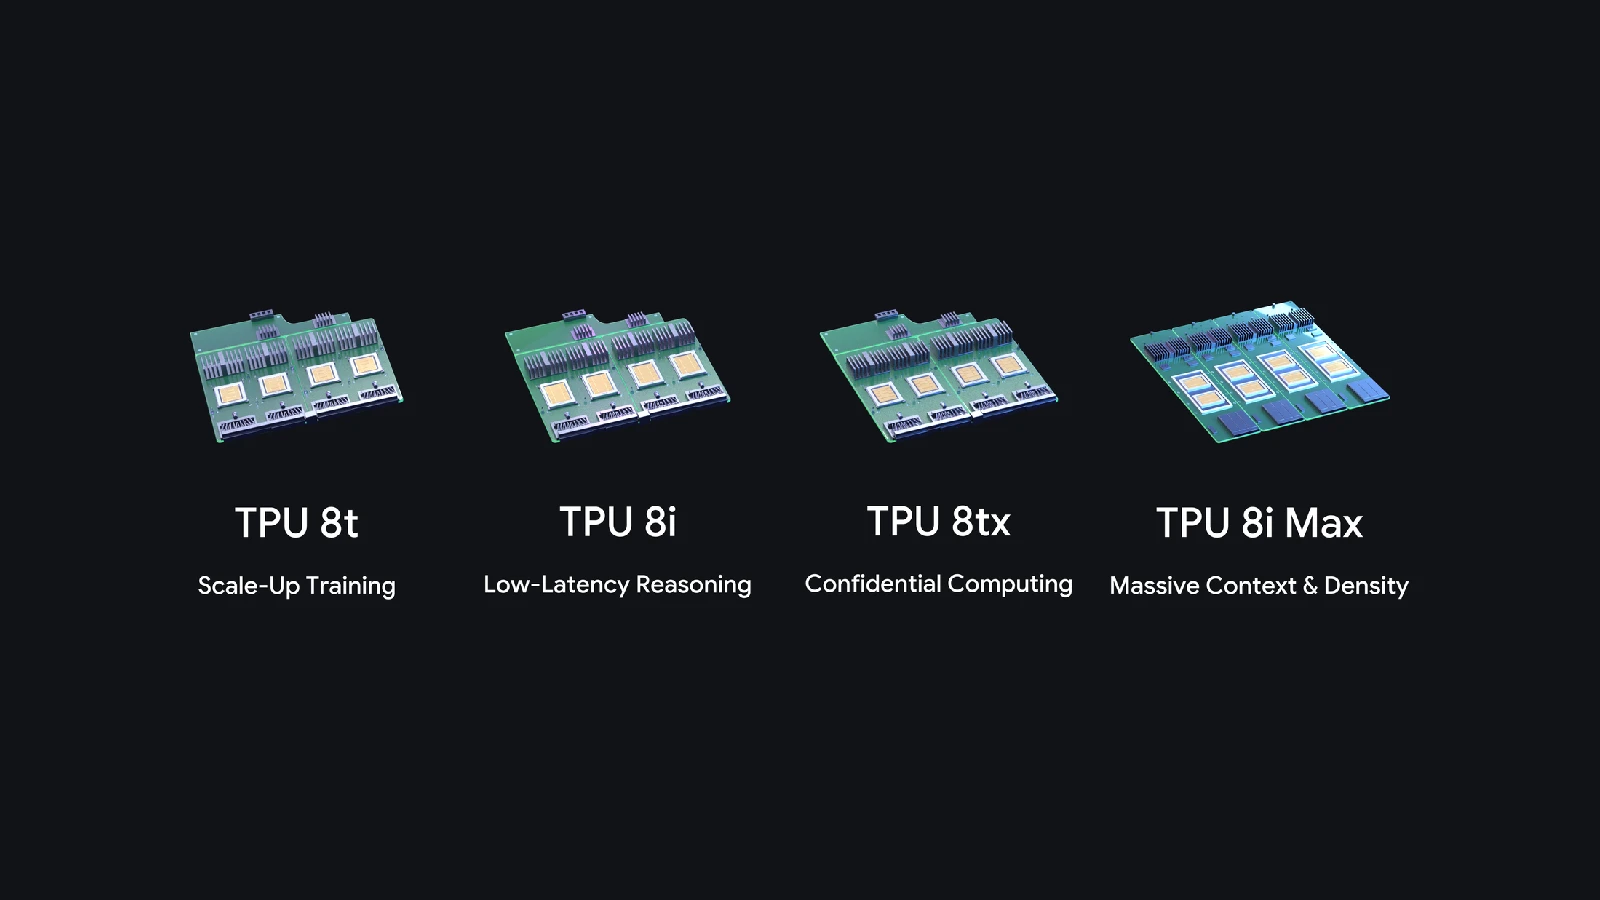
Google は 2026 年 11 月 10 日 (現地時間)、第 8 世代 TPU の新しいシステムとして、機密性の高いデータの処理に向けた「TPU 8tx」と、長い文脈の処理に向けた「TPU 8i Max」を発表しました。
TPU は、Google が Gemini の学習や提供、Google Cloud のサービスに使っている AI 処理専用の半導体で、4 月に発表された「TPU 8t」と「TPU 8i」を合わせると、4 つの TPU システムが登場したことになります。
第 8 世代 TPU は 4 つのシステムに
TPU は、10 年以上前から音声認識や翻訳といった Google 社内の用途のために設計が始まっており、現在は Gemini の学習と提供、自律的にタスクを進める AI エージェントの処理、Google Cloud の顧客向けサービス、顧客のデータセンターへの導入などに使われています。
今回発表された 2 つは新しいチップではなく、既存のチップを土台に、計算、ネットワーク、ストレージなどを組み合わせたシステムとして設計されており、TPU 8tx は TPU 8t と同じシリコンに、カスタムの AMD 製 CPU ホストを組み合わせ、TPU 8i Max は TPU 8i のチップ 2 つを 1 つのパッケージにまとめています。
Google によると、チップの設計には複数年かかりますが、システムであれば特定の用途に合わせたものを数か月で用意できるとしています。
第 8 世代の 4 つのシステムの役割は次のとおりです。
- TPU 8t: 大規模な学習向け。前世代比で最大 2.7 倍の学習性能
- TPU 8i: 低遅延の推論向け。前世代比で推論の価格性能比が 80% 向上し、チップ間の通信遅延を最大で半分に短縮
- TPU 8tx: 機密データを扱う推論向け。小規模な学習にも対応
- TPU 8i Max: 長いコンテキストの処理向け。ラックあたりの演算密度が最も高い
なお、学習はモデルを作る処理、推論は完成したモデルが応答を返す処理を指します。
TPU 8tx は処理中のデータもハードウェアで保護
データは保存時やネットワークでの送信時には暗号化されますが、処理中はメモリ上で暗号化を解く必要があり、TPU 8tx はこの処理中のデータと AI モデルの重みもハードウェアの層で保護して他から隔離します。
ネットワークには、リアルタイムの推論向けの低遅延な「Boardfly」を採用し、TPU 8t と比べて遅延は最大 2 分の 1 で性能の低下はほぼありません。
対象は、フロンティアモデルや独自のモデル、AI エージェントを機密性の高いデータと一緒に動かす規制の厳しい企業や政府です。
非公開データを使った追加学習 (ファインチューニング)、大きなモデルから小さなモデルを作る蒸留、強化学習によるエージェントの訓練を、データを別のクラスターに移さずに 1 つのシステムで行えます。
TPU 8i Max は 8i のチップを 2 つ搭載
多数の AI エージェントがソフトウェアのコード全体や数時間分の動画を同時に扱うと、メモリの帯域が足りなくなり処理が詰まります。この問題に対応するため、TPU 8i Max は低遅延の TPU 8i のチップ 2 つを 1 つのパッケージにまとめています。
演算性能、SRAM (チップ内の高速なメモリ)、HBM (大容量の高速メモリ) の帯域幅が、いずれも TPU 8i の 2 倍となっており、既存のラックと同じ設置面積に 2 倍のシリコンを載せられるため、データセンターは面積・電力あたりでより多くの計算能力を導入できます。
TPU を使いやすくするソフトウェアの強化
Google は、TPU を汎用のハードウェアと同じ感覚で使えるようにするため、ソフトウェアも拡充しています。
- TorchTPU: 先月オープンソース化。PyTorch のコードや Hugging Face のモデルを書き換えずに TPU で実行でき、vLLM や SGLang 向けの TPU 用バックエンドも用意
- TPU エージェントスイート (プレビュー): Claude Code、Cursor、Google Antigravity などのコーディングツールに組み込み、TPU の導入作業、ボトルネックの診断、処理の自動調整を自然言語で指示
- XLA Serving Engine: Python で学習したモデルを、低遅延の C++ ランタイムで TPU、GPU、CPU に配信
- Agent Compute Engine: 待機中の AI エージェントのセッションを自動で停止し、作業中の記憶をチップの外へ数ミリ秒で退避
- TPU Sync: オープンソース。チップ上のメモリ、ホストのメモリ、共有ストレージ、ネットワークを 1 つのメモリ階層として扱い、長い文脈を保持するデータ (KV キャッシュ) の転送遅延と、最初の応答が返るまでの時間を 90% 以上短縮
- Cloud Pathways: Google Kubernetes Engine (GKE) で一般提供。複数のスライスにまたがる TPU を 1 台のマシンのように操作
- GKE dynamic slicing: 一般提供。TPU の構成を組み替えることで、ジョブの起動を最大 5 倍、障害からの復旧を最大 4.5 倍高速化
実際の AI の処理でも結果が出ており、InferenceX と AgentX のベンチマークでは、TPU 上の vLLM-TorchTPU のソフトウェアが、価格性能で最先端の結果を記録しています。
ベンチマークは、エージェント型のコーディングや長いコンテキストの処理を想定した内容で、Google は同じハードウェアのままソフトウェアの最適化を進め、結果をさらに伸ばすとしています。
次世代の TPU の開発にも AI が使われており、Google DeepMind の AlphaChip (強化学習を使ったチップ設計システム) や Gemini を使い、チップの配置設計を数週間から数時間に短縮したと説明しています。