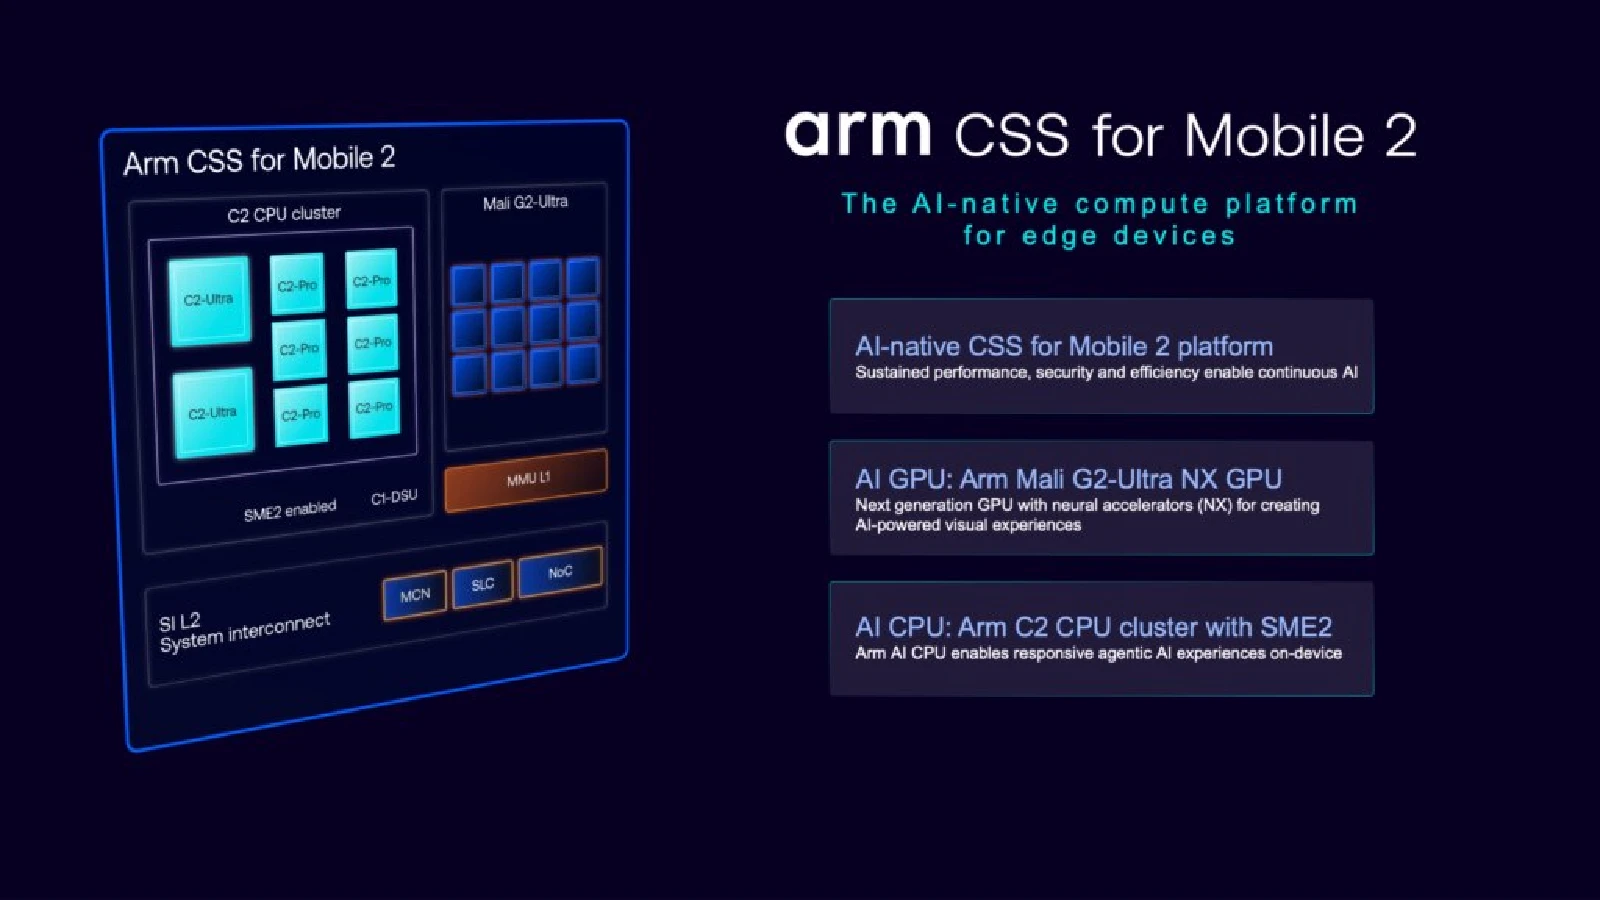
Arm は 2026 年 9 月 8 日(現地時間)、モバイル向けの新しいコンピュートプラットフォーム「CSS for Mobile 2」を発表しました。
このプラットフォームは、エージェント型 AI とニューラルグラフィックスの処理需要に対応するため、新 CPU クラスター「Arm C2」と新 GPU「Mali G2-Ultra NX」を組み合わせ、システム全体で AI 処理を最適化する設計になっています。
C2-Ultra CPU は性能向上より省電力性能の伸びが大きい
新 CPU クラスターの上位コア「C2-Ultra」は、前世代の C1-Ultra と比較してピーク性能が最大 15% 向上するとしています。
パイプライン幅は前世代から変わっておらず、命令実行ウィンドウを 30% 拡大 (同時実行中の命令数が約 2000 から 2600 に増加) し、投機実行や依存関係の検出を高速化することで、データ待ちの時間を減らす方向の改善が中心になっています。
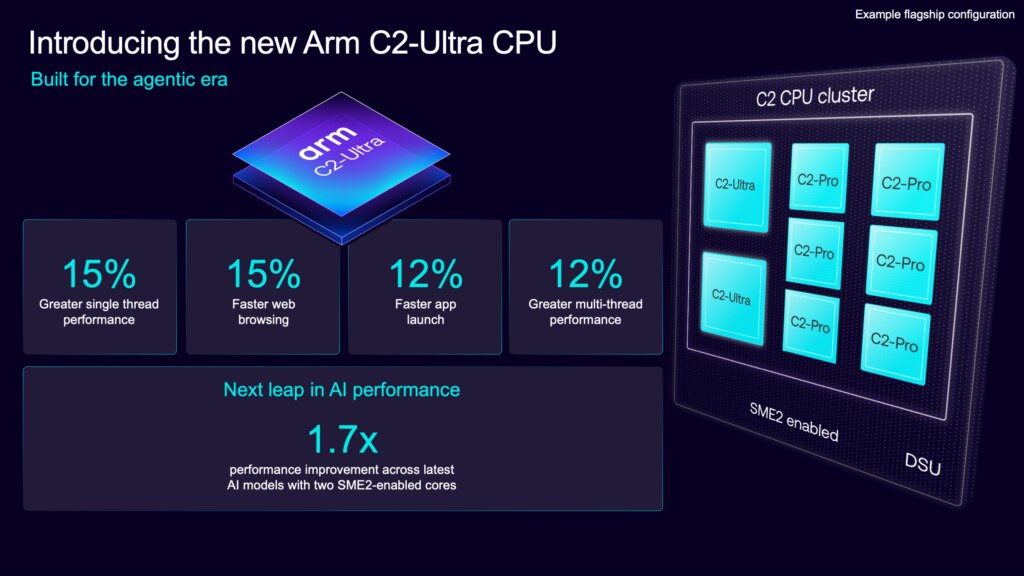
一方で、同じ性能を維持したまま消費電力を 38% 削減できるとしており、2nm プロセスへの移行と合わせて電力効率が向上しています。
なお、C2-Premium・C2-Pro・C2-Nano の 3 コアについては、アーキテクチャ自体は前世代の C1 系から大きく変わっていません。
AI 性能は最大 1.7 倍、SME2 ユニットは 2 基に
AI 性能では、行列演算を高速化する SME2 (Scalable Matrix Extension 2) ユニットを前世代の 1 基から 2 基に倍増したことに加え、低精度演算の高速化や、メモリ帯域の消費を抑える Lookup Table Instructions (LUTi) の活用により、前世代から最大 1.7 倍向上しています。
また、SME2 のクロック周波数も前世代の最大 2GHz から最大 3GHz に引き上げられています。
Arm によると、実際の処理では音声認識の遅延が 40% 短縮されるほか、メモリからのユーザー設定・過去の操作履歴の検索速度が 41% 高速化、AI モデルの応答生成における最初のトークン出力までの時間が 25% 短縮されるとしています。
Mali G2-Ultra NX は GPU 内にニューラルアクセラレータを統合
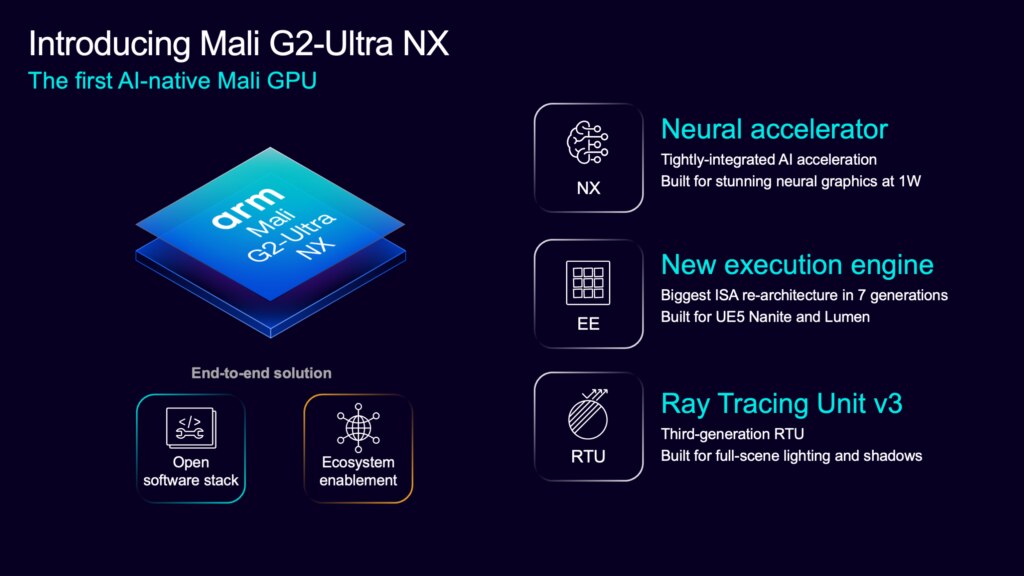
GPU の「Mali G2-Ultra NX」は、シェーダーコア内にニューラルアクセラレータを組み込んだことで、新しい実行エンジンと第 3 世代のレイトレーシングユニットと合わせ、低解像度画像から高解像度を再構成するニューラルアップスケーリングや、フレーム生成による滑らかな描画といった処理を GPU 上でネイティブに実行できるとしています。
アーキテクチャの改善のみでベンチマーク性能が最大 24% 、AI を使わない通常のゲーミング性能でも 14% 向上するとしており、ニューラルアップスケーリング技術と組み合わせることで最大 120 FPS でのプレイも視野に入るとのことです。
CPU・GPU 間のデータ移動を支える新しいシステムインターコネクト「SI L2」も統合されており、CPU・GPU・その他のシステムリソースが同時に動作する際のレイテンシ低減や帯域幅の確保に対応します。
対応チップと採用状況
CSS for Mobile 2 は完成した SoC ではなく、CPU・GPU・システム IP を組み合わせた設計基盤で、各半導体メーカーが個別の IP を選んで独自の SoC に組み込みます。
Arm はパートナー各社の製品名を公表していませんが、リファレンス設計では、エントリー向けの C2-Pro 2 基 + C2-Nano 4 基構成から、フラッグシップ向けの C2-Ultra 2 基 + C2-Pro 6 基構成までが示されています。
年内には、少なくとも 1 社のパートナーから 10 〜 12 コア構成のチップが登場する見込みだとしており、現時点では、Xiaomi の折りたたみスマートフォン「Xiaomi 18 Fold」に搭載される独自チップ「XRing O3」のみが採用を確認しています。
なお、前世代の Arm C1 は MediaTek の Dimensity 9500 のほか、Google Pixel 11 シリーズの Tensor G6 にもすでに採用されています。現時点では、CSS for Mobile 2 世代を次期 Tensor チップが採用するかどうか分かっていません。