Google は 2026 年 9 月 23 日 (現地時間)、音声生成モデル Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS を公開したことを発表しました。
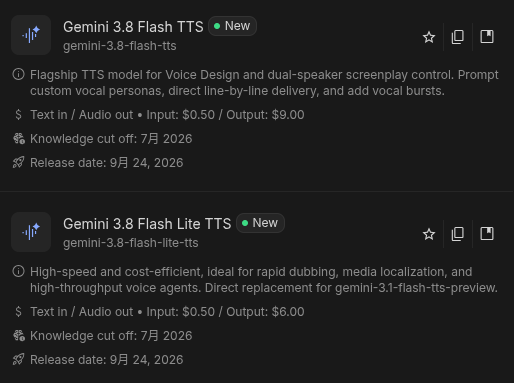
Gemini 3.8 Flash TTS はキャラクター音声のデザインやセリフ単位の演技指定に強みを持つ創作向けモデルで、Gemini 3.8 Flash-Lite TTS は大量処理や低コスト運用に最適化されたモデルとなっています。
両モデルは Gemini API と Google AI Studio で同日から利用できるようになっています。
テキストプロンプトから音声をデザイン、2,000 種類以上のボイスも用意
Gemini 3.8 Flash TTS は、テキストプロンプトによる自由なキャラクター音声のデザインと、台詞単位での細かな演技指定に対応したモデルです。ゲームやオーディオブック、ポッドキャストといった創作用途を主な対象としています。
役柄やアクセント、声質などをテキストプロンプトで指定するだけで、100 以上の言語・方言に対応したオリジナル音声を一から作成できます。メキシコスペイン語やケベックフランス語、スコットランド英語といった地域バリエーションを含む、2,000 種類以上の完成済み音声ライブラリも用意されています。
さらに、30 秒程度の音声サンプルから一貫した声質を再現する音声複製機能も搭載されました。この機能の利用には、音声提供者本人によるサンプルと一致する同意録音が必要とされており、生成された音声には SynthID による電子透かしと C2PA のコンテンツ認証情報が付与されます。
今後は、既存のライブラリ音声を音程やアクセントなどの観点からプロンプトで微調整できる「ボイスリミックス」機能も追加される予定です。
台詞単位での演技指定や 2 話者シーンにも対応
Gemini 3.8 Flash-Lite TTS は大量処理や低コスト運用に最適化されたモデルで、吹き替えや音声エージェントなど、スケールを重視する用途に向けた位置付けです。
両モデルでは、台詞ごとに間の取り方や方言の切り替え、あいづちなどを細かく指定した演技の作成が可能です。数時間規模の連続音声でも声質のブレを抑えた生成ができるとしており、ポッドキャストやオーディオブックといった長時間コンテンツでの活用を想定しています。
1 つの台本から 2 話者による会話シーンを自然な間で演じ分ける機能や、笑い声やため息といった非言語音、あいづちの挿入によって会話に臨場感を持たせる機能も備えています。
ベンチマークでも高評価、企業との連携も
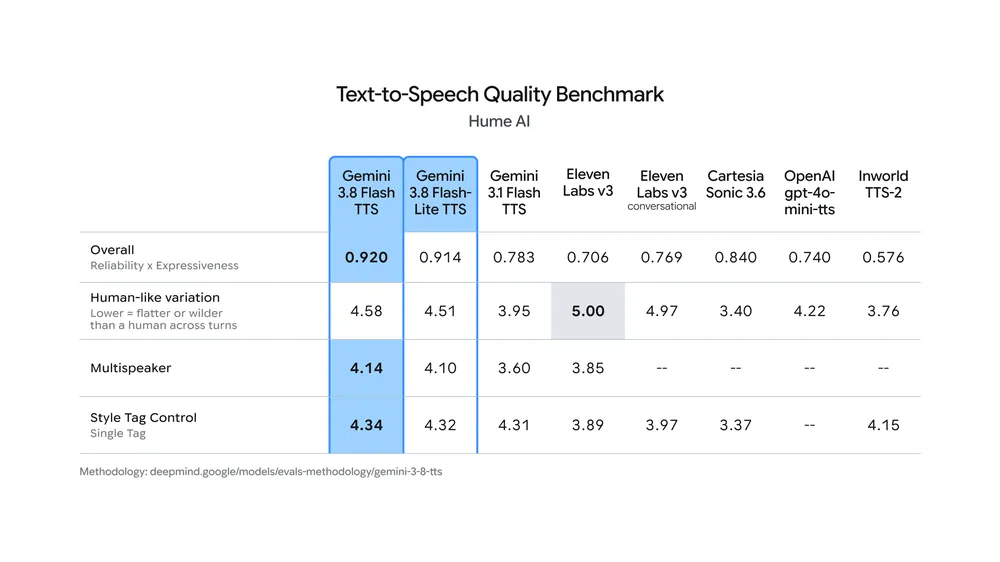
Gemini 3.8 Flash TTS は、Hume AI の Voice Design Benchmark で総合 1 位を獲得したことが確認されています。また、Gemini 3.8 Flash TTS と Flash-Lite TTS は、同じく Hume AI の Overall Quality Index でそれぞれ 1 位、2 位を獲得したとしています。
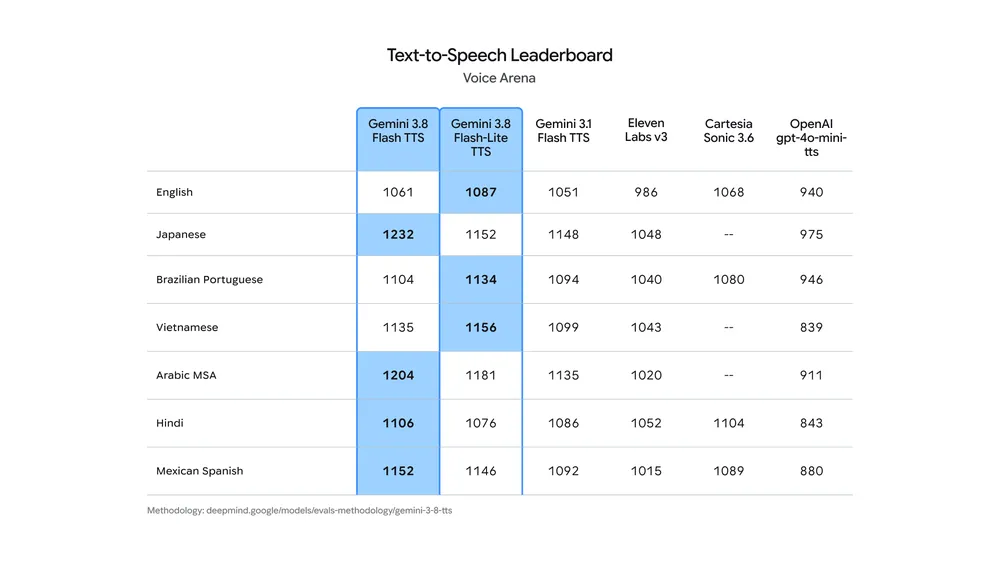
日本語を含む複数の主要言語の人間による評価においても、両モデルは競合の中で上位に位置付けられたとしています。
Figma や HeyGen、Wondercraft など複数の企業が、吹き替えや多言語ローカライズ、音声エージェント構築といった用途でこれらのモデルの統合を進めているとしています。
提供時期
Gemini 3.8 Flash TTS は、開発者向けに Gemini API と Google AI Studio で、一般ユーザー向けには Gemini Notebook で、それぞれ本日から利用可能です。
Gemini 3.8 Flash-Lite TTS も同様に、開発者向けに Gemini API と Google AI Studio で、一般ユーザー向けには Google Vids で本日から利用可能となっており、
どちらも企業向けの Gemini Enterprise 対応は今後予定されています。