
Google は 2026 年 9 月 16 日 (現地時間)、Android アプリ開発向けの AI コーディングベンチマーク Android Bench を大幅に刷新し、Android Bench 2.0 として公開したことを発表しました。
今回のアップデートでは、数日から 1 週間規模の複雑な開発作業を評価する長時間タスク (LHT) が新たに導入されたほか、エージェント単位での評価やモデルの継続スコアリングも追加されています。
長時間タスクの評価を新たに導入
従来の Android Bench は小規模なバグ修正などが中心でしたが、Android Bench 2.0 では依存関係の更新やアプリの新規開発、Android 移植など、数日から 1 週間規模の「長時間タスク (LHT)」評価が追加されました。
また、評価フレームワークも Harbor へ統一されています。
合否ではなく継続スコアリングで評価
複数日にわたる複雑なタスクでは、要件の大半を満たしていても 1 つのエラーで 0 点になる二値評価では実態を捉えきれません。
そこで機能性や見た目の忠実度から完了率を算出する「継続スコアリング」を採用しました。この評価基準のもと、LHT の最高合格率は約 28% となり、従来タスク (約 91%) を大きく下回りました。
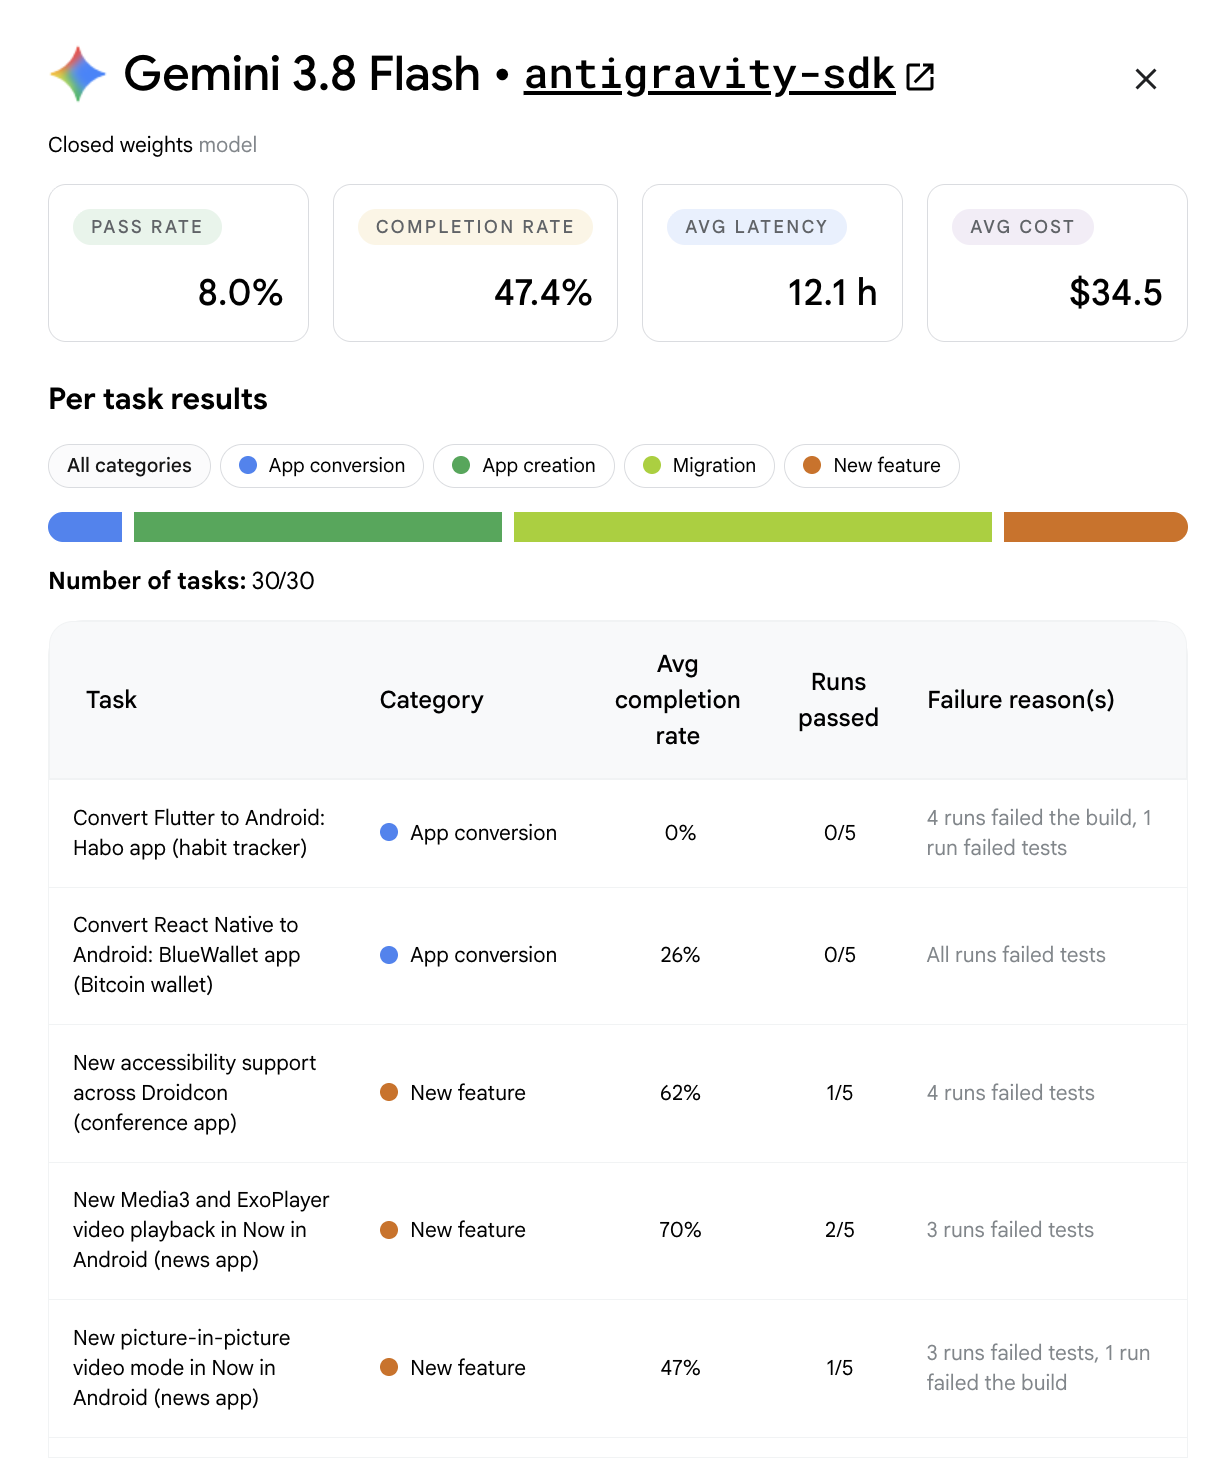
リーダーボードでは、各モデルのカード表示から合格率や完了率、タスクあたりの平均コストなどを確認できます。
モデルはリファクタリングより新規コード作成が得意
長時間タスクでは、コード量よりもアーキテクチャの複雑さが成否を左右するため、既存コードのリファクタリングや移行作業は難易度が上がる傾向にあります。
Java から Kotlin への変換など確立された定型処理は、125 以上のファイル・8,000 行超のコードでも一貫して適用可能です。
一方、依存性注入などのランタイム検証や破壊的変更、未公開ライブラリが絡むタスクでは精度が低下します。クロスプラットフォームの Android 移植も合格率 100% のモデルはなく、完了率は最大 80% です。
モデル単体だけでなく、エージェントも含めて評価
モデル単体に加え、Codex 上の GPT-5.6 Sol や Google Antigravity 上の Gemini 3.8 Flash のように、エージェントと組み合わせた評価も始まりました。
プロンプトキャッシュ等によるトークン削減効果も確認されており、ハーネス設計が開発者の成果に直結することが示されています。
新モデルの追加
なお、今回の更新で Gemini 3.8 Flash や Anthropic の Fable 5.1 などがリーダーボードに加わり、総合トップは合格率 28% の OpenAI GPT-6 Astra となっています。
Google は、モデルとエージェントの組み合わせ拡大を含め、Android Bench の評価対象を今後も広げていく方針を示しています。